リアルタイムの API インジェスト
500 以上の取引ペアからの価格、出来高、注文帳データは、低レイテンシの API 接続を通じて継続的に取得され、小売業向けツールで一般的なバッチ遅延パターンを回避します。
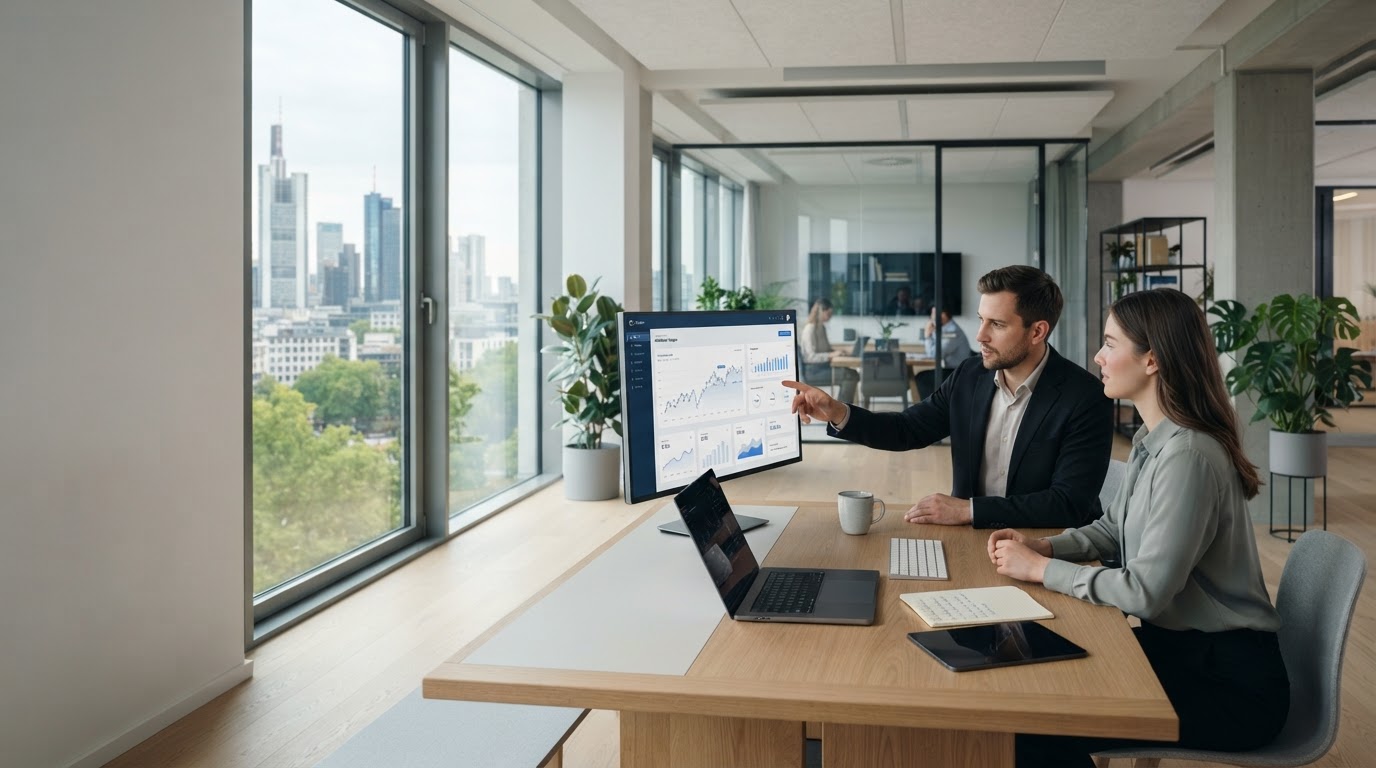
Cedar Anlagrove は 500 以上の取引ペアをリアルタイムで処理し、生の市場データをリスク加重された洞察に変換し、取引フロアがなくても、どのタイムゾーンからでも行動できるようにします。
機関のデスクは、他の誰よりもミリ秒前にデータに基づいて行動することで成功します。ホームオフィスやコワーキングスペースで働く独立系投資家が同じ取り込みパイプラインにアクセスできることはほとんどないため、すでに数分前の情報に基づいて意思決定が行われることがよくあります。
この遅延は静かに悪化します。スプレッドの変化、センチメントの変動、流動性のギャップは、手動レビュー担当者が最初のダッシュボードを読み終える前に解決されます。 Cedar Anlagrove はそのギャップを埋めるために存在します。金融機関が依存しているのと同じカテゴリのリアルタイム処理が、資金をリモートで管理する単一のオペレーター向けに再編成されています。
3 つのコンポーネントが順番に動作します。それぞれは、人間の意思決定者にノイズが届く前にノイズを低減するように設計されており、その決定に取って代わるものではありません。
500 以上の取引ペアからの価格、出来高、注文帳データは、低レイテンシの API 接続を通じて継続的に取得され、小売業向けツールで一般的なバッチ遅延パターンを回避します。
市場解説や注文フローパターンからの自然言語シグナルをボラティリティクラスタリング分析と組み合わせて、価格に完全に反映される前に変化を特定します。
相関ペア間の流動性マッピングは、機会が提示される前に、予測リターンだけでなくエクスポージャーによって機会をランク付けする重み付けレイヤーに情報を提供します。
| パラメータ | 仕様 | なぜそれが重要なのか |
|---|---|---|
| 資産範囲 | 主要会場およびクロスマーケット会場で 500 足以上 | 単一会場のデータから死角を減らす |
| 取り込みのレイテンシ | 1 秒未満の連続ストリーム | 信号の関連性をリアルタイム状態に近づけます |
| モデリングアプローチ | ボラティリティのクラスタリング + 感情の重み付け | 構造的に意味のある動きからノイズを分離する |
| 出力フォーマット | リスクを加重してランク付けした推奨リスト | ユーザーの判断を失わずに迅速なレビューをサポート |
これらのシナリオは、場所に依存しないキャリアとともに資本を管理する専門家が直面する繰り返しの状況を説明しています。
市場の時間と労働時間が一貫性なく重なっている場合、複数の地域にわたるエクスポージャを管理することは困難です。 500 以上のペアにわたる継続的なモニタリングは、最後に手動チェックが行われた 8 時間前の正確なデータではなく、現在の条件に対してポジションがレビューされることを意味します。
相関ペア間の価格の不一致は、大規模な参加者によって検出されるとすぐに解消されます。流動性マッピングは、これらのウィンドウが形成されるときに表面化し、専用の監視デスクを必要とせずに、遠隔地の投資家に同等の反応時間を与えます。
顧客との電話や旅行のためにボラティリティが一時停止することはありません。エクスポージャーが定義されたリスクしきい値を超えると、アラートが自動的に生成されるため、投資家は事後的に変化を発見するのではなく、リターンに基づいて行動できるようになります。
ここでは信頼を築くために体験談やランキングは使用されません。代わりに、プロセス自体がレイアウトされているため、独自の条件でメソッドを判断できます。
価格、出来高、注文フローのデータは、フィルタリングや解釈が適用される前に、直接 API 接続を通じて 500 以上のペアから取得されます。
受信データはボラティリティ クラスタリング モデルと照合して、構造的に意味のある動きを短期的なノイズやフィードの不規則性から分離します。
検証されたシグナルは、ランク付けされたリスク重み付けされた推奨事項に変換されます。最終的な決定とそれに対する責任はあなたにあります。
ここでの答えは意図的に具体的です。購読の決定に重要な詳細がある場合は、営業上の会話ではなく、このセクションに記載します。
データの取り込みは継続的に実行され、検証レイヤーは、毎日または毎週の固定スケジュールではなく、新しいデータが到着すると条件を再評価します。これは、推奨事項が前回のセッションのスナップショットではなく、現在の市場構造を反映していることを意味します。
現在、主要市場およびクロスマーケット取引所にわたる 500 以上の取引ペアをカバーしています。生のペア数を最大化するのではなく、一貫したデータ品質を維持するために、カバレッジは定期的に見直されます。
データの処理は、データの最小化やストレージ制限の原則など、該当する EU データ保護要件に従います。インフラストラクチャと処理の記録は、必要に応じて標準準拠のレビューをサポートするために維持されます。
いいえ。プラットフォームは分析とリスクを考慮した推奨事項を生成します。執行の決定は常にユーザーに委ねられ、自律取引システムではなく意思決定支援ツールとしてのエンジンの役割と一致します。
セットアップには数週間ではなく、数分かかります。ライブ分析のレビューを開始するために、組織のオンボーディング、専用ハードウェア、最小チーム規模は必要ありません。
組織的なセットアップは必要ありません。